

Notch での ONNX AI モデル
Notch 2026.2 以降では、AI Model Post-FX ノードを介して Notch で ONNX(Open Neural Network Exchange)AI モデルを実行し、Disguise メディアサーバーの NVIDIA GPU 上で映像をリアルタイムに処理できます。このページでは、Disguise ハードウェアで動作する内容と注意すべき点を扱います。完全なセットアップおよび使用手順については、Notch 公式の ドキュメント を参照し、動画 をご覧ください。
Notch には、ここでは扱わない YOLO、AI Hand Tracker、AI Face Tracker ノードなど、組み込みの AI 統合機能も付属しています。
- Notch 2026.2 の新機能 で、AI Model Post-FX ノードを介して利用します。この最初の実装では、image-to-image(画像から画像)モデルのみ に対応しています。
- インポート時に、Notch はモデルを、マシンの正確な GPU・ドライバー・CUDA バージョンに最適化された TensorRT エンジンファイル(
.trt)にコンパイルします。そのため.trtファイルはマシン固有となり、プロジェクトを別のメディアサーバーに移すと再コンパイルが実行されます。 - 一部のモデルはインポートするとすぐに実行できます。その他のモデルは動的テンソルを使用しており、Notch の Inspector(インスペクター) で寸法を設定する必要があります。
Disguise メディアサーバーでの要件
Section titled “Disguise メディアサーバーでの要件”- 対応する NVIDIA GPU。どのサーバーが Notch を実行できるかについては、Notch v1.0+ 互換性表 を参照してください。AMD GPU は CUDA に対応していないため、Notch で AI モデルを実行できません。
- CUDA、TensorRT、および互換性のある NVIDIA ドライバー。 起動時に、Notch 2026.2 は CUDA 12.9、TensorRT 10.15.1、および NVIDIA ドライバー 576.02 以降を必要とします。現在のバージョンとインストール手順については Notch のドキュメントを確認してください。
- モデルの読み込み・変換・実行に十分な ビデオメモリ(VRAM)。
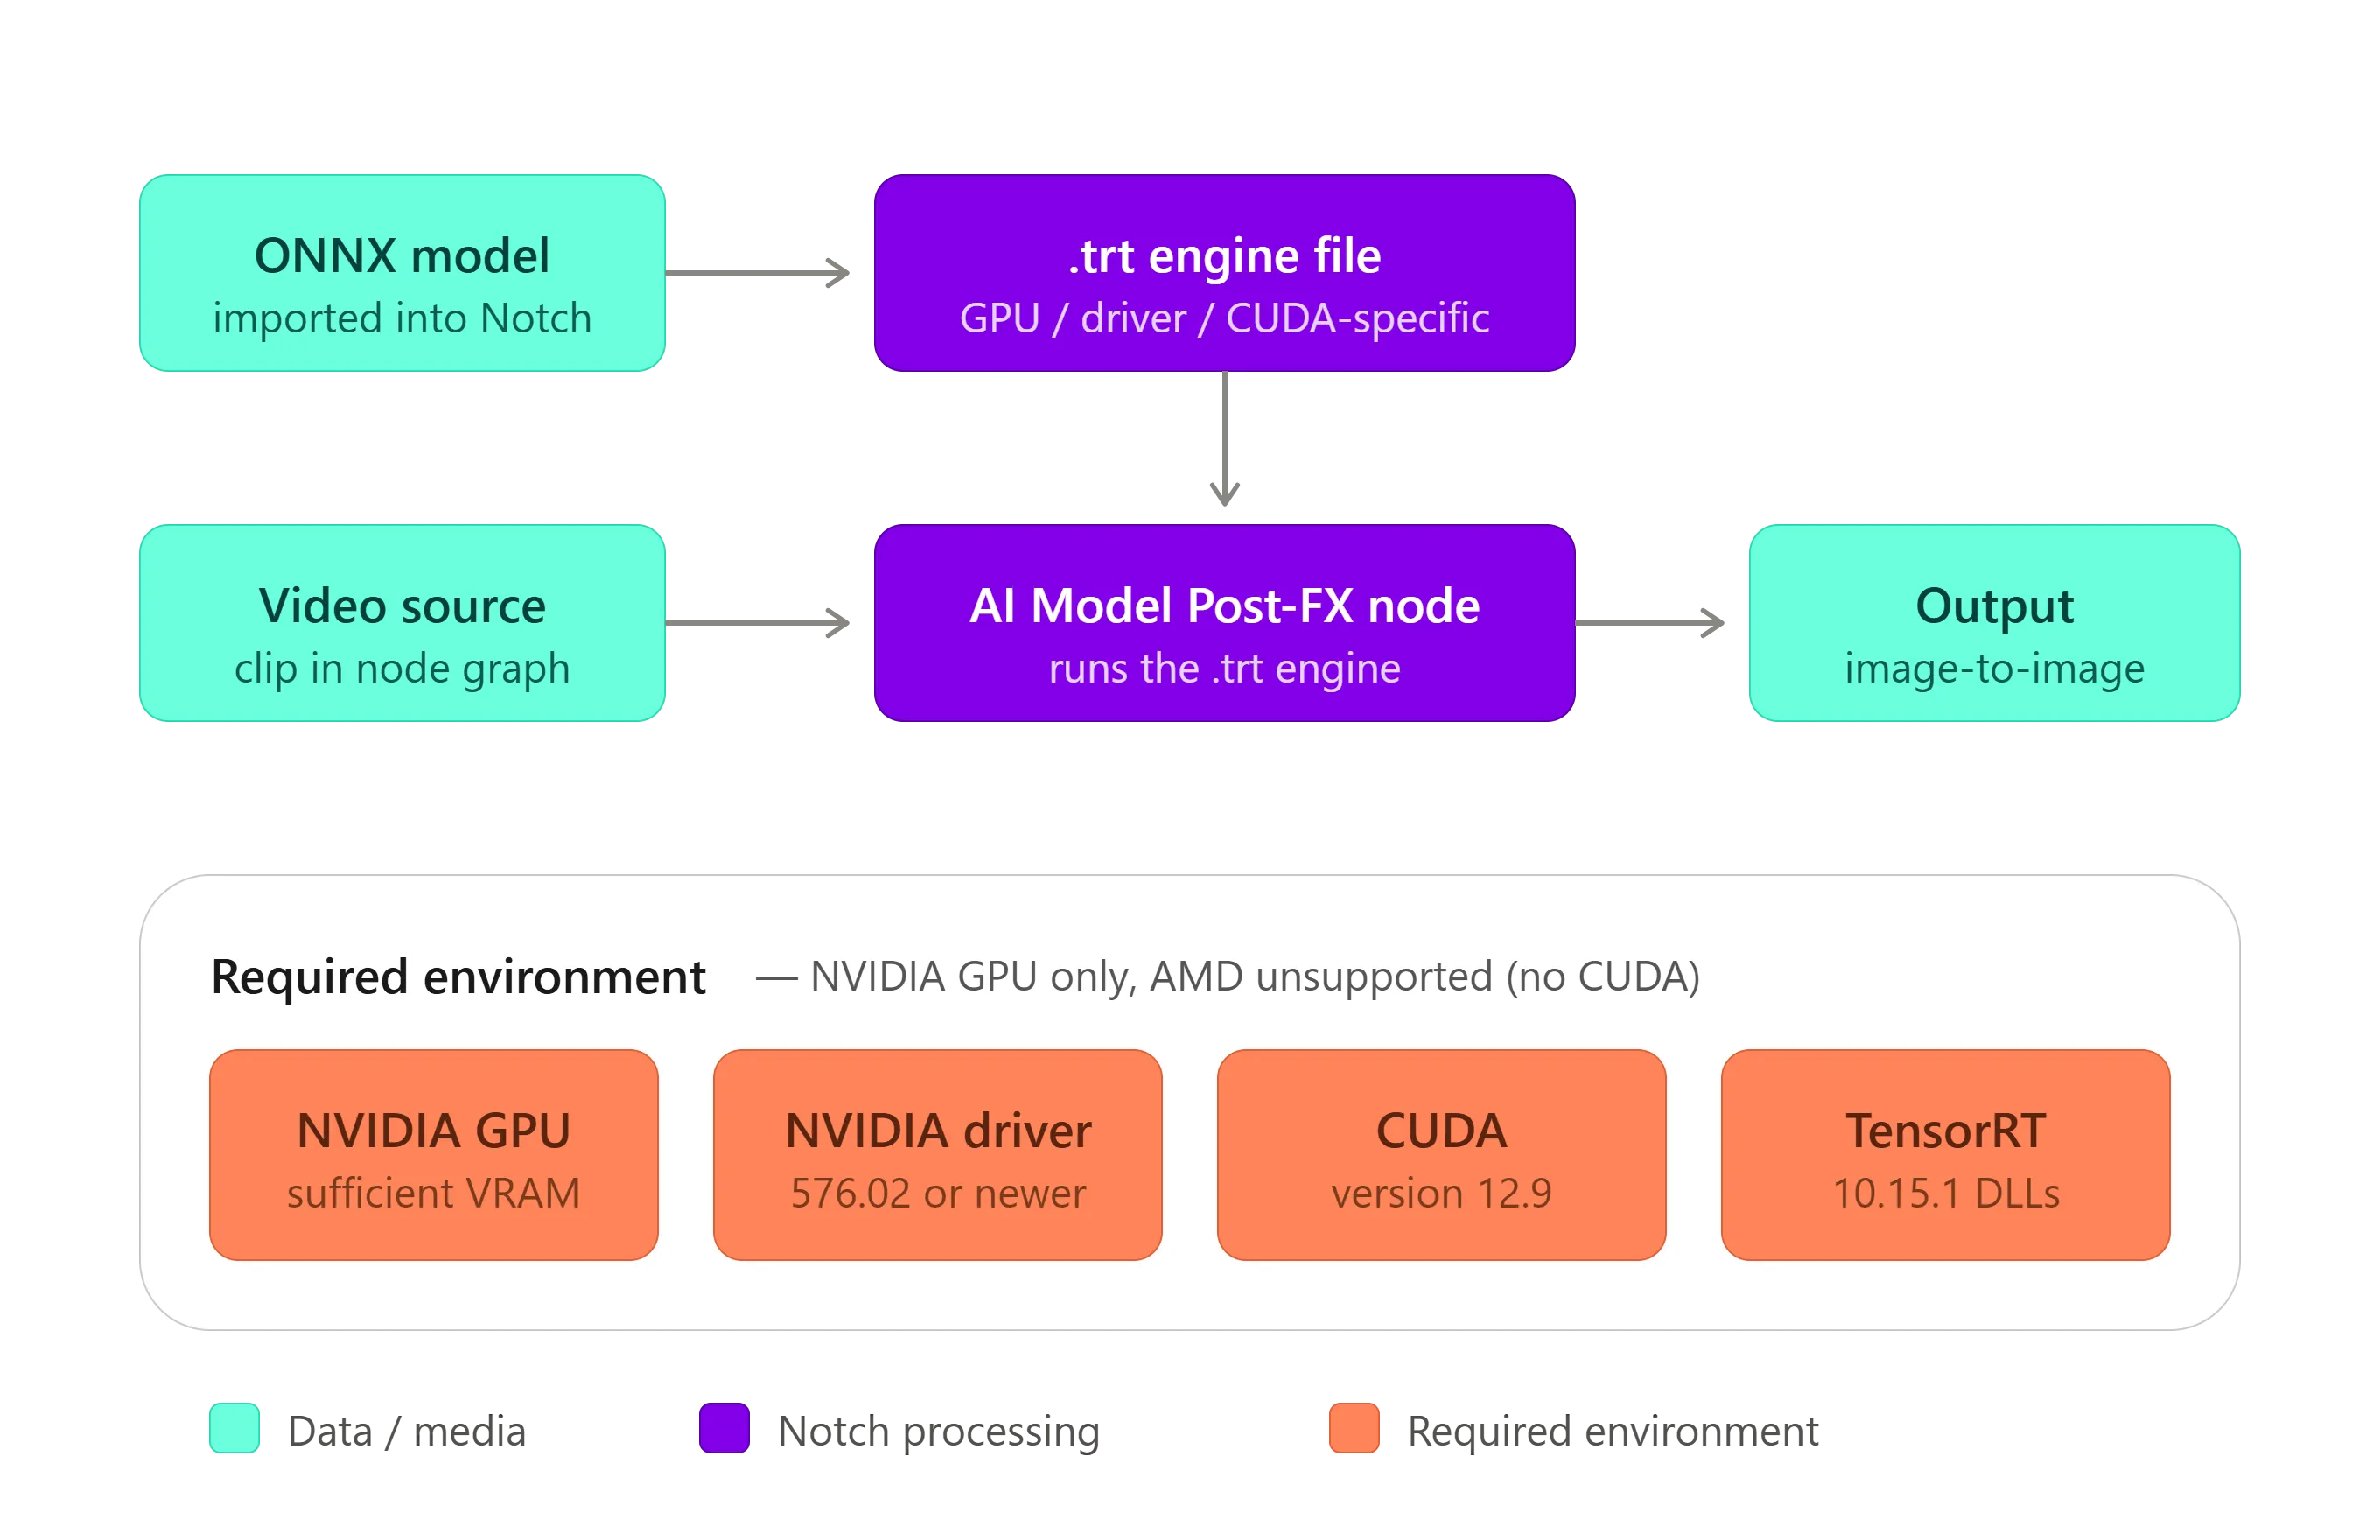
Disguise メディアサーバーでの Notch 2026.2 AI モデルワークフローと必要な環境。
- NVIDIA Background Removal は、Notch の ONNX モデルワークフローと併用すると正しく機能しない場合があります。
- 一部の Disguise メディアサーバーには ロックされた NVIDIA ドライバーバージョン があり、要件を満たさない場合があります。そのため、サーバーが Notch の必要とするドライバーを実行できるか確認してください。
- AI モデルの読み込み・変換・実行に十分な VRAM が利用可能である必要があります。
- AMD GPU は対応していません。
セットアップと使用方法
Section titled “セットアップと使用方法”完全かつ最新の手順については、Notch 公式ドキュメントに従ってください。これには、CUDA と TensorRT のインストール、TENSORRT_DIR 環境変数の設定、Import Resource > AI > ONNX Model からのモデルのインポート、Inspector(インスペクター) での動的テンソルの管理、および実行できないモデルのトラブルシューティングが含まれます。
トラブルシューティング
Section titled “トラブルシューティング”ONNX モデルは要件がかなり厳格なため、実装が難しい場合があります。以下は最もよくある問題と、それを特定して解決するための手順です。AI モデルに固有ではない、Notch ブロック全般の問題については Notch トラブルシューティング を参照してください。
ブロックの読み込み時間
Section titled “ブロックの読み込み時間”ONNX モデルを使用すると、Notch はブロック内で使用するためにモデルを .trt ファイルにコンパイルします。この変換はマシンにインストールされている GPU、ドライバーバージョン、CUDA バージョンに固有のもので、.trt ファイルの生成にはモデルの複雑さに応じてかなりの時間がかかることがあります。
ブロックを読み込む際にはこの点にご注意ください。特に本番環境では、メディアサーバーごとに異なる GPU モデルを使用している場合があります。その場合、ハードウェア構成ごとにモデルを変換する必要があります。
- ブロックを事前に読み込んでおく。 リハーサルの前にメディアサーバーへ読み込んでおいてください。
- VRAM を確認する。 モデルの読み込み・変換・実行に必要な VRAM があることを確認してください。
メディアサーバーとの統合の詳細については、Notch マニュアルの Notch ブロックでの AI を参照してください。
ブロック内でモデルが動作しない
Section titled “ブロック内でモデルが動作しない”通常、次の 3 つのいずれかが原因です。
- CUDA バージョン。 正しい CUDA バージョンがインストールされており、インストール済みの GPU ドライバーと互換性があることを確認してください。CUDA のインストールまたはドライバーバージョンが正しくないと、
.trtファイルは正常に生成されません。 - TensorRT の DLL。 環境変数が正しく設定されていること、および指定したパスに TensorRT の DLL が存在することを確認してください。DLL は、マシンにインストールされている CUDA のバージョンとも一致している必要があります。
- AI モデルのパス。 Notch ブロックは、ブロックの作成時に使用したものと同じパスで AI モデルファイルにアクセスできる必要があります。モデルが移動された場合やパスが変更された場合、ブロックは必要な
.trtファイルを生成できません。
詳細なセットアップ手順については、Notch マニュアルの AI モデル を参照してください。
CUDA Toolkit のインストール後に Genlock または出力が動作しなくなった
Section titled “CUDA Toolkit のインストール後に Genlock または出力が動作しなくなった”CUDA Toolkit のインストーラーには 2 つのオプションがあります。
- Express は、CUDA Toolkit と推奨される NVIDIA GPU ドライバーの両方をインストールします。互換性のあるドライバーとあわせて CUDA をインストールするため、通常は開発用ワークステーションに適した選択肢です。
- Custom は、既存の GPU ドライバーを更新せずに CUDA Toolkit をインストールします。メディアサーバーではこの違いが重要です。メディアサーバーソフトウェアとの互換性のために、特定のドライバーバージョンが必要となる場合があるためです。
メディアサーバーのハードウェアで作業する場合は、インストーラーが認定済みの GPU ドライバーを置き換えないよう、Custom を選択してください。
一部のマシンでは ONNX モデルを再生できるが、他のマシンでは再生できない
Section titled “一部のマシンでは ONNX モデルを再生できるが、他のマシンでは再生できない”本番環境では、サードパーティ製のファイル同期ソフトウェアを使用してマシン間でフォルダーを同期することがよくあります。ONNX モデルを同期する場合は、モデルファイル自体(.onnx ファイル)のみを対象としてください。フォルダー全体を同期しないでください。
生成された .trt ファイルは、ONNX モデルと同じディレクトリに保存されます。.trt ファイルは各マシンの GPU、ドライバーバージョン、CUDA バージョンに固有のものであるため、システムごとに専用の .trt ファイルが必要になる場合があります。あるマシンで生成した .trt ファイルを構成の異なる別のマシンにコピーすると、読み込みに失敗したり、予期しない動作をしたりすることがあります。